AI locale vs cloud: cosa conviene a una PMI nel 2026?
Fino a un paio d’anni fa la scelta era semplice: se volevi usare un modello linguistico di qualità, dovevi passare per il cloud. GPT-4, Claude, Gemini — roba che girava solo sui server di chi li aveva costruiti. I modelli open pesanti (Llama 2, Falcon) esistevano, ma servivano hardware fuori portata per una PMI.
Nel 2026 la situazione è completamente diversa. E la domanda “locale o cloud?” è diventata una delle decisioni più concrete che un’azienda italiana deve prendere quando inizia a usare sul serio l’intelligenza artificiale.
Cosa è cambiato#
Tre cose hanno ribaltato lo scenario.
I modelli open-weight sono diventati competitivi. DeepSeek V3.2, Llama 4, Mistral Large 2, Qwen 3.5 — modelli che su benchmark coding e ragionamento tengono testa a GPT-4o e Claude Opus, e girano su hardware che un’azienda può comprare senza farsi male. Il divario di qualità che nel 2023 era abissale, oggi è ridotto a casi d’uso di nicchia.
Il costo dell’hardware è sceso. Una RTX 5090 con 32 GB di VRAM costa circa 2.000 €. Un server con una GPU A10G o due RTX 4090 sta sotto i 10.000 €. Per la maggior parte dei carichi di lavoro aziendali — assistenza clienti, analisi documenti, riassunti, classificazione — basta e avanza.
Strumenti come Ollama, LM Studio e vLLM hanno reso banale il deploy locale. Non serve più un team ML. Scarichi un tool, scegli un modello da una lista, e in cinque minuti hai un’API compatibile con OpenAI che gira sulla tua macchina.
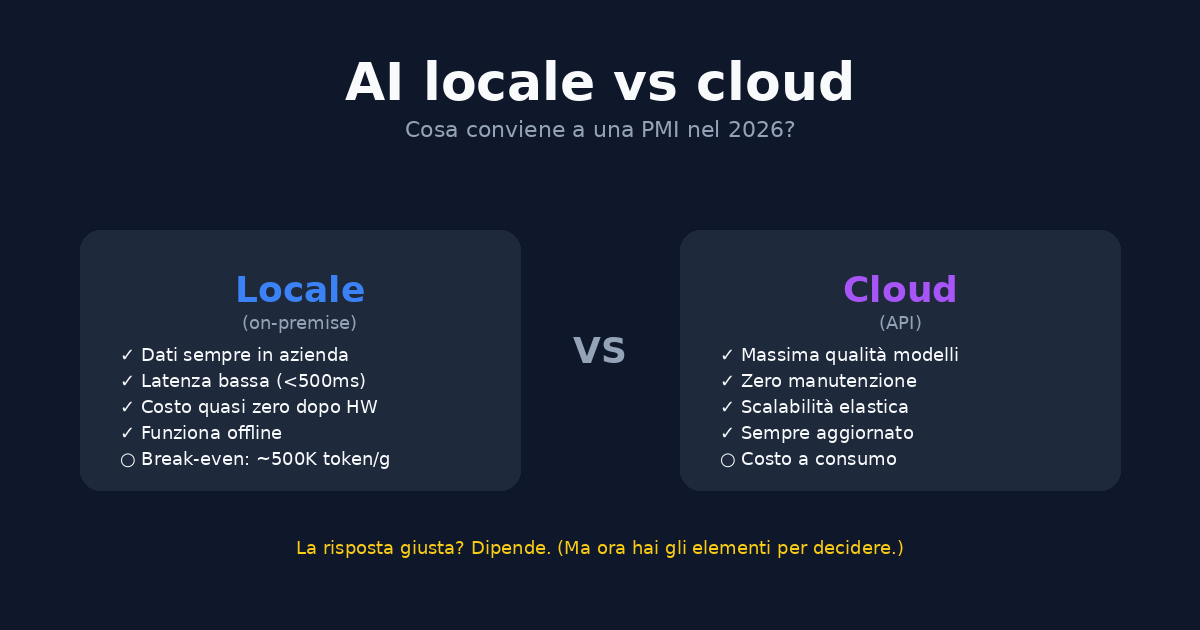
Locale vs cloud: il confronto#
| Aspetto | Locale (on-premise) | Cloud (API) |
|---|---|---|
| Qualità risposte | Molto buona su modelli recenti (Llama 4, DeepSeek V3, Mistral Large 2) | Massima, specie su ragionamento complesso (Claude Opus, GPT-5.6) |
| Costo a volume | Quasi zero dopo l’investimento iniziale | $0.15–10 per milione di token a seconda del modello |
| Break-even | Circa 500.000 token/giorno per modelli 7B; 2M/giorno per 70B | Sotto quella soglia è più economico |
| Latenza | 200–500ms (senza bottleneck di rete) | 1–3 secondi (dipende da API e posizione) |
| Privacy | I dati non escono mai dal perimetro aziendale | I dati viaggiano su server terzi; verificare policy e GDPR |
| Manutenzione | Hardware, aggiornamenti, backup. Serve qualcuno che ci metta le mani. | Zero manutenzione. Paghi e funziona. |
| Scalabilità | Limitata dalla GPU installata | Elastica: paghi ciò che consumi |
| Disponibilità | Sempre, anche senza internet | Dipende dallo stato del servizio |
Scenario concreto: una PMI manifatturiera da 50 dipendenti#
Prendiamo un’azienda che vuole automatizzare tre attività:
- Classificazione email e ticket assistenza — circa 200 al giorno
- Riassunto di documenti tecnici e preventivi — 30–50 pagine/giorno
- Chatbot interno per manualistica e procedure — uso continuo
Stima volumi: circa 1–2 milioni di token/giorno.
Soluzione cloud: a $2.50/1M input (modello medio) = $5–15/giorno → $150–450/mese. Qualità alta, setup zero.
Soluzione locale: server con RTX 4090 (~3.500 € una tantum). Costo marginale: corrente elettrica e qualche ora di manutenzione al mese. Break-even in 8–12 mesi.
Dopo il primo anno, la soluzione locale costa un decimo. Prima degli 8 mesi, il cloud è più economico.
La domanda giusta non è “quale è meglio”, ma “tra quanto recupero l’investimento, e posso permettermi l’hardware adesso?”
Come iniziare con l’AI locale#
Se vuoi partire, il percorso è semplice:
- Prendi una macchina con GPU. Un PC con RTX 4060 (16 GB VRAM) basta per modelli fino a 8B parametri. Per modelli più grandi (30B+, 70B) servono RTX 5090, A5000, o Mac Studio con Apple Silicon unificata (64+ GB).
- Installa Ollama.
curl -fsSL https://ollama.com/install.sh | shsu Linux, download su macOS/Windows. - Scegli un modello.
ollama pull llama4,ollama pull deepseek-v3,ollama pull mistral-large— dipende da quanto hardware hai. I modelli da 7-8B girano su qualsiasi GPU moderna e bastano per il 90% dei compiti aziendali. - Esponi l’API. Ollama di default serve su
localhost:11434. Puoi esporla in LAN per usarla dai tool interni. - Collega i tuoi strumenti. La maggior parte dei tool (Open WebUI, Anything LLM, n8n, Home Assistant, e chiunque supporti API OpenAI) può puntare direttamente a Ollama cambiando l’URL dell’endpoint.
Esistono anche soluzioni chiavi in mano: GPT4All di Nomic, LocalAI, o appliance come le stazioni AI di Lambda Labs, che offrono interfacce pronte senza toccare riga di comando.
Cosa l’AI locale non sa fare (ancora)#
Essere onesti è parte del nostro stile, quindi vediamo i limiti.
- Ragionamento complesso. Se hai bisogno di analisi multi-step, contesti lunghi (100k+ token), o catene di ragionamento sofisticate, i modelli cloud top di gamma (Claude Opus, GPT-5.6) sono ancora un gradino sopra.
- Multimodalità pesante. I modelli locali gestiscono immagini, ma la generazione video o audio di alta qualità è ancora appannaggio del cloud.
- Aggiornamenti in tempo reale. Un modello locale è fermo alla versione con cui lo deployi. Le API cloud si aggiornano continuamente — ricevi miglioramenti senza fare nulla.
- Manutenzione hardware. La GPU si rompe? Il modello non parte più. Serve un minimo di competenza IT o un contratto di assistenza.
La strategia intelligente: ibrida#
Quasi nessuno dei consulenti che seguono il settore consiglia più tutto-locale o tutto-cloud. La strategia più sensata per una PMI italiana è ibrida:
- Modelli locali per il 70-80% dei carichi: compiti ripetitivi, dati sensibili, operazioni che richiedono latenza bassa. Ci metti i modelli da 7-70B che girano su una GPU dedicata.
- Cloud per il 20-30%: compiti che richiedono il massimo della qualità, ragionamento complesso, o volumi variabili imprevedibili. Paghi solo quando serve.
Questo è esattamente il pattern che vediamo emergere in tutte le analisi del 2026. Un gateway LLM (tipo LiteLLM o OpenRouter) in mezzo instrada automaticamente le richieste semplici al modello locale e quelle complesse al cloud — senza che l’utente finale si accorga della differenza.
Conclusione#
Nel 2026, l’AI locale non è più un esperimento per smanettoni. I modelli open-weight hanno chiuso il gap qualitativo, l’hardware costa quello che costa una macchina aziendale, e gli strumenti di deploy sono maturi.
Per una PMI italiana con volumi di token medio-alti, dati sensibili da proteggere, e voglia di indipendenza tecnologica, la scelta locale ha senso economico e operativo. Per chi fattura 200 richieste al giorno o ha bisogno del massimo della qualità, il cloud resta la risposta giusta.
La vera risposta, come sempre, è: dipende. Ma ora hai gli elementi per decidere.